随机森林参数设置有哪些_随机森林5关键参数调参技巧
1. n_estimators:决策树的数量
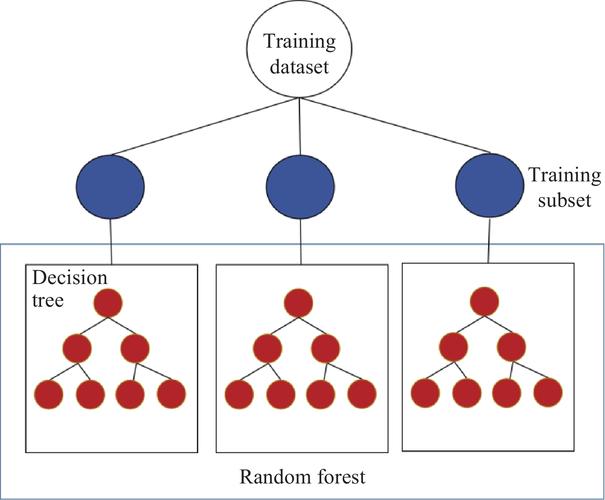
随机森林中的决策树数量(`n_estimators`)是一个关键的超参数,它直接影响模型的性能和训练时间。增加决策树的数量通常能提升模型的稳定性,减少过拟合的风险,但同时也会增加训练时间和内存消耗。在实践中,通常建议设置一个较大的数值(如100或200),然后通过交叉验证等方法进行调优。例如,当数据集较大或特征较多时,增加决策树数量可能会显著提升模型的泛化能力。
2. max_features:每次分裂考虑的最大特征数
`max_features` 参数控制每棵树在分裂时考虑的最大特征数。这个参数的设置可以降低决策树之间的相关性,从而避免过拟合。常见的取值包括“auto”或“sqrt”,表示考虑特征数量的平方根,或者“log2”,表示考虑特征数量的对数。也可以设置为具体的整数或浮点数,表示考虑的特征绝对数或百分比。例如,当特征数量较多时,减少 `max_features` 的值通常能获得更好效果。
3. max_depth:决策树的最大深度
`max_depth` 参数限制决策树的最大深度,防止模型过拟合。若不设置,决策树可能会继续生长,直至每个叶子节点只有一个样本。通常建议根据数据集的复杂度和样本量来设置这个参数,常用的取值范围在10到100之间。例如,当数据集较小或特征较少时,可以不限制 `max_depth`,但如果样本量较大且特征较多,建议限制这个值以防止过拟合。
4. min_samples_split:拆分内部节点所需的最小样本数
`min_samples_split` 参数规定了拆分内部节点所需的最小样本数。若节点的样本数小于该值,则不再进行拆分。这个参数的设置可以帮助模型避免在数据量较少的节点上进行过度分割,从而提高模型的鲁棒性。例如,当数据集存在噪声或类别不平衡时,适当增大这个值(如设置为3-5)往往能显著提升模型在测试集上的表现。
5. min_samples_leaf:叶子节点所需的最小样本数
`min_samples_leaf` 参数表示叶子节点所需的最小样本数。若叶子节点的样本数小于该值,则会对该节点进行剪枝。这个参数的设置可以帮助模型避免生成过于复杂的决策树,从而提高模型的泛化能力。例如,当数据集较大且特征较多时,适当增大这个值(如设置为3-5)往往能显著提升模型在测试集上的表现。
参考资料
1. 机器学习之随机森林的参数调整和用Python进行AI数据分析进阶教程_python进行随机森林回归分析中模型参数调优?-CSDN博客
2. 随机森林 5 大核心参数深度解析:从 max_depth 到 min_samples_leaf 的避坑指南-CSDN博客
3. 随机森林组件参考与参数配置-人工智能平台 PAI-阿里云-人工智能平台 PAI(PAI)-阿里云帮助中心
4. 随机森林的参数说明 - 光彩照人 - 博客园
5. sklearn之随机森林--实现机器学习——RandomForestClassifier-CSDN博客
随机森林参数设置有哪些_随机森林5关键参数调参技巧
随机森林有5个关键参数:1) `n_estimators` 控制决策树数量,增多能提升稳定性和泛化能力,但增加训练时间;2) `max_features` 控制每棵树分裂时考虑的特征数,减少树间相关性